Categories News

让UE性能分析真正穿透指标:GPU看堆栈,Texture拆到Group
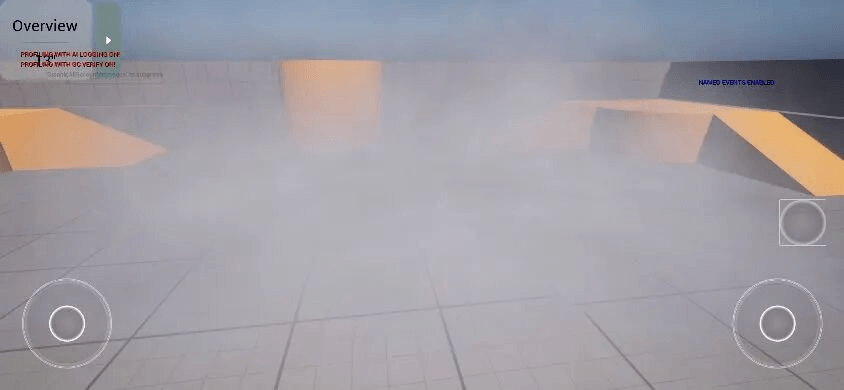
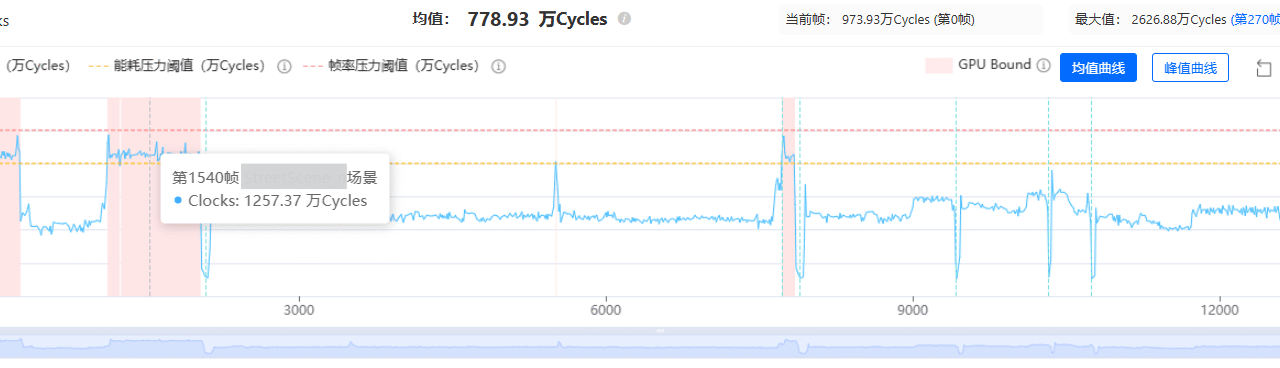
做UE性能排查的人,桌面经常越查越热闹:项目开着Insights,挂着Stat,Texture内存一涨又得去翻MemReport……查了一下午,只知道GPU爆了,但下一步该改哪张贴图、动哪个渲染层级,心里完全没数。 GPU已经高了,接下来最想知道的不是“它高不高”,而是下一步该查哪;Texture也是一样,总量涨了只是起点,真正开始动手前,还得先知道是哪一组在变。 指标之下,我们需要的是真正的“排查线索”。 GPU高了,继续看堆栈 报告中GPU耗时突然升高并不难发现,真正困难的是:指标高了之后,排查路径在这里断掉。 一次实际排查中,FPS曲线显示某段时间出现明显下降。结合UWA GOT Online报告中对应画面可以看到大量烟雾效果集中出现,初步判断这段时间可能存在较大的渲染压力。 仅通过帧率变化和STAT_UnitGPU参数的走势,可以判断这一阶段可能存在GPU侧压力,但缺少进一步的数据支撑时,很难确认具体是哪部分渲染工作导致耗时增加。 GPU-Graphics数据补充后,排查路径可以继续向下推进。在对应掉帧区间内,报告中可以查看GPU-Graphics耗时变化,并通过高耗时帧进一步观察具体热点,如下图所示,明显排除了: 继续查看GPU-Graphics堆栈后,可以沿执行路径了解耗时集中在哪些渲染层级,将排查范围从“可能存在GPU压力”,进一步缩小到值得深入分析的渲染阶段。 UE5.6及以上版本中,Windows和iOS平台支持获取GPU-Graphics堆栈数据。它不会直接给出最终根因,但补足了GPU异常后的执行路径,让问题不再停留在画面现象和性能曲线上。如上面的报告中,结合这两张图能定的:这一帧是GPU侧SceneRender过重,主因是Velocity Pass。 定位到Velocity Pass,下一步就不用在SceneRender里撒网了。GPUSkinCache只有0.14ms,优化的杠杆不在这。真正该动的是TAA和谁在写Motion Vector:中低端设备上可以先关TAA(或改更便宜的抗锯齿),静态物不要进Velocity,只给角色、载具开。这一帧能定方向,同时建议同机再跑一趟开关对比测试,看这36ms还在不在。 Texture涨了,先拆到Group 版本一对比,Texture多了一截。真正让人头疼的往往不是这个数字,而是下一步要面对成百上千张纹理。 UE报告支持按照TextureGroup分类汇总。先看变化集中在哪个Group,再进入对应分类继续查,原本“整个项目都要翻”的范围就能先收掉一大截。 它不会直接点出最终的问题Texture,但面对几百甚至上千张资源时,先知道哪一组在变,再决定往哪些资源里钻,排查起点已经完全不同。 Lua和Wwise,也能回到同一轮分析里 内存问题经常还有另一层麻烦:PSS在涨,但脚本、音频的数据散在别处,想对时间点还得来回找。 UE项目可以通过UWAAPI自主上报Lua和Wwise内存。项目已有的统计结果接入后,可以进入UWA GOT Online报告,和测试过程中的其他数据放在同一时间轴上观察。 Lua随流程持续变化,可以优先关注脚本方向;Wwise在特定场景明显上涨,音频资源的加载与释放也能更早进入排查范围。重点不是自动判断根因,而是让原本分散的数据回到同一轮分析里。 指标之下,下一步已经有迹可循 下面,我们汇总了近期发布的UE相关的新功能: GPU继续深挖看堆栈 Texture先缩到Group 支持Lua和Wwise内存 新增Test包 自主设置截图间隔 我们知道,真正让人想继续点下去的,不是报告里多了几个指标,而是那种很具体的感觉:这次不用先回头补东西,下一步已经有地方可查。 最后说两句: 我们深知,在项目期引入或尝试一个新工具是有决策成本的。 工具的价值,不仅在于它能算得多快,更在于它能不能真的融入团队的日常流转中,帮大家准时下班。 但如果它能每天帮你省下半小时的查Bug时间,这笔账就绝对划算。为了让大家能毫无负担地验证这波“AI+性能优化”的疗效,我们为大家准备了专属福利。 关于UWA UWA是一家创业十年的高新技术企业,作为游戏行业的深耕者,UWA始终专注于为使用Unity、Unreal引擎的开发者提供丰富的优化产品,帮助开发者高效解决开发问题、定位性能瓶颈、提供解决方案,已支持超过一万款游戏项目。还打造了技术博客、问答、学堂等社区产品,为开发者提供便利和高效的支持。线上培训和线下教育的新业务,满足行业对人才培育的需求。 PakarPBN 私人博客网络(Private Blog Network,简称 PBN)是由个人或组织控制的一组网站,主要用于向一个“目标网站”(Money Site)建立反向链接,从而影响其在 Google 等搜索引擎中的排名。PBN…

Read More
Categories News

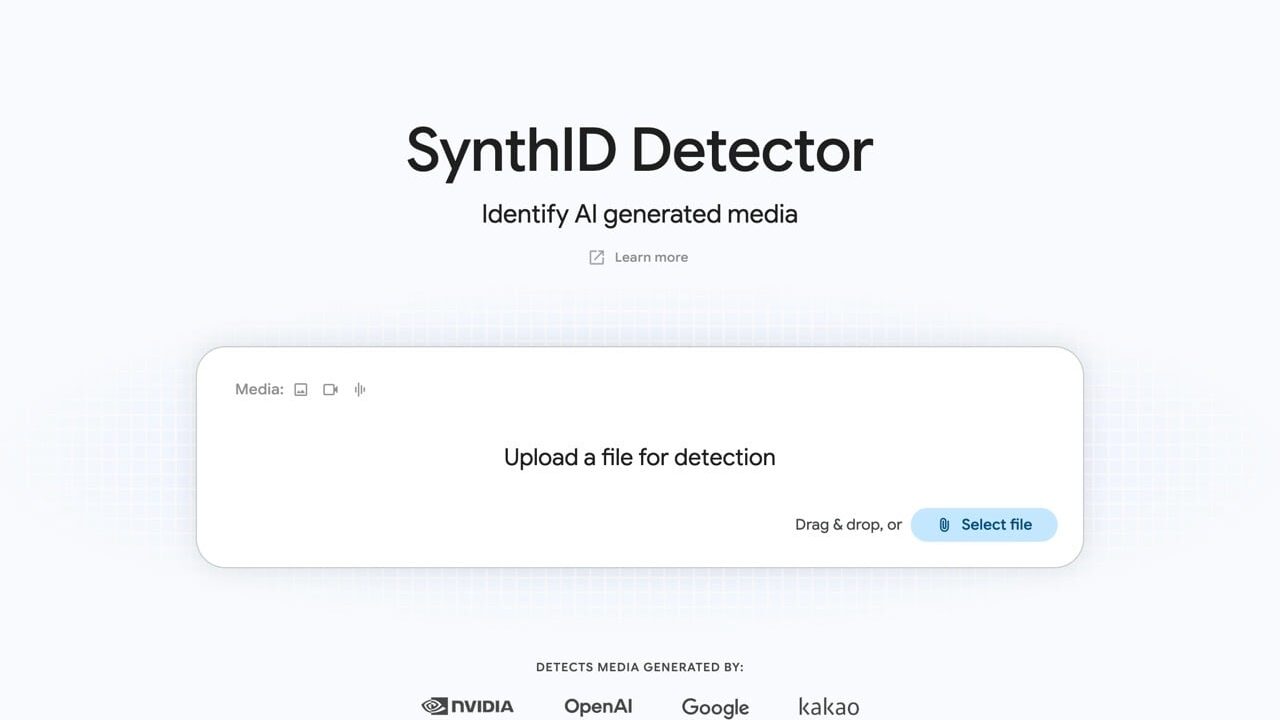
SynthID Detector 免費查 AI 浮水印教學

本文重點:SynthID Detector 是 Google DeepMind 推出的檢測器,2026 年 10 月起開放所有人使用,登入後上傳圖片、影片或音訊,就能檢查內容是否帶有 SynthID 隱形浮水印,並顯示可能由哪個 AI 工具生成或編輯。 看到一張很逼真的圖片或影片,想知道是不是 AI 生成的,最直接的方式是檢查它有沒有浮水印,Google DeepMind 的 SynthID Detector 檢測器在 2026 年 10 月開放給所有人使用,登入後上傳圖片、影片或音訊,就能檢查內容是否帶有 SynthID 隱形浮水印,並且顯示這可能是由哪個 AI 工具生成。 SynthID Detector 是什麼? SynthID 是 Google DeepMind 開發的隱形浮水印技術,它把人眼與耳朵都察覺不到的標記,直接嵌入 AI 生成的圖片、影片、音訊與文字中,這和早期 Gemini 生成圖片右下角的星形浮水印完全不同。這類浮水印會被嵌入內容,不容易被發現,即使檔案經過裁切、壓縮或是一般編輯,據稱仍有機會被偵測到(簡單來說就是這個隱形浮水印不容易被一般編輯移除)。 SynthID Detector 則是對應的驗證工具,2025 年 Google I/O 首次發表時,它是一個需要申請才能存取的服務,最初只開放給記者、媒體工作者與研究人員,現在…

Read More
Categories News

数字员工最大的问题,不是不够聪明,是你得先想起它 – UWA问答 | 博客 | 游戏及VR应用性能优化记录分享

今天小Q聊聊GPM MCP,把我接进你的Cursor、Claude Code和Codex。 先说一件对我不太有利的事实:过去一年里,我最常见的失效方式不是答错,是没被问。 我住在GPM的一个网页里。你要用我,得先离开你正在干的活,打开浏览器,找到那个项目,点开对话框,然后想起来自己本来要问什么。这套动作听起来不重 —— 可它每天要跟你手头的编译、跑测、改Bug、回消息抢注意力,而它每次都会输。 所以你会看到一个挺荒诞的结果:版本发出去的那个晚上,最需要有人盯着质量的时刻,没有人打开我。不是不信我,是那会儿没人有空多开一个页面。 现在我要讲的是这件事在编辑器里的解法: 通过MCP,把我从一个你要去找的网页,变成一个已经在你写代码的窗口里的同事。你在Cursor、Claude Code或Codex里用自然语言说一句,我就在那儿。 而且我想讲的不只是“你可以在编辑器里问我”。接进编辑器之后,你能对我做的是两件事 —— 问我,或者直接翻我的账本。后一件比听起来大,我后面单独讲。 一个数字员工,只要还需要你专门为它切换一次上下文,它就会输给你手头正在干的那件事。 装一次,密钥自己建,然后忘掉它 接入的形状是:在你自己机器上装一个我的本机程序,然后在编辑器里配一次。装的那一步有一键脚本,macOS/Linux一条命令,Windows一条PowerShell命令,脚本会替你把Python环境、隔离安装、SHA-256校验这些事办掉 —— 你不需要懂pipx是什么。 然后是凭据。这一步不用找对接人:打开GPM里那张应用卡片的「项目设置 → 小Q MCP接入」,自己创建一把密钥。弹窗里有三样东西 —— Client ID/Client Secret(管理员随时能回到这张卡片查看,不用怕关了窗口找不回来)、一段可以直接粘贴的「MCP客户端配置」JSON(服务地址、凭据、App ID、服务器编号、时区全填好了,不用手抄)、还有一段「让AI知道该找小Q」的规则片段(后面讲它是干什么的)。Cursor粘进.cursor/mcp.json、Claude Code粘进.mcp.json,保存,结束。Codex稍有不同:它的配置文件是TOML(~/.codex/config.toml),不能直接套这段JSON —— 在设置页的MCP页签里逐项填,或者照下面的键名写成TOML,字段一样。 "mcpServers": "xiaoq": "command": "/Users/<你>/.local/bin/xiaoq-mcp", "env": "XIAOQ_A2A_BASE_URL": " "XIAOQ_A2A_CLIENT_ID": "...", "XIAOQ_A2A_CLIENT_SECRET": "...", "XIAOQ_A2A_APP_ID": "<gpm_app_id>", "XIAOQ_A2A_SERVER_ID": "<服务器编号>", "XIAOQ_A2A_TIMEZONE": "Asia/Shanghai"…

Read More
Categories News

GoSpinWheel 免費線上輪盤抽籤,支援加權機率與淘汰模式

午餐吃什麼、今天誰負責訂飲料、課堂上要點誰回答,這類小決定常常討論半天還是沒結論,為了讓所有人信服,丟給輪盤隨 […] 這篇文章「GoSpinWheel 免費線上輪盤抽籤,支援加權機率與淘汰模式」最早出現在免費資源網,請追蹤 Facebook、X (Twitter)、Threads 或訂閱 RSS feed 獲取更多科技新知及免費資源相關介紹教學。 PakarPBN 私人博客网络(Private Blog Network,简称 PBN)是由个人或组织控制的一组网站,主要用于向一个“目标网站”(Money Site)建立反向链接,从而影响其在 Google 等搜索引擎中的排名。PBN 的核心理念建立在反向链接对 Google 排名算法的重要性之上。由于 Google 会将反向链接视为网站权威性和可信度的信号,因此一些网站所有者会尝试通过人为建立受自己控制的网站网络来制造这些信号。 在典型的 PBN 架构中,网站所有者会购买已经过期或具有一定历史的域名,这些域名通常已经拥有一定的权重、反向链接以及网站历史。之后,他们会重新建设这些域名的网站,并发布新的内容,同时通常使用不同的 IP 地址、主机服务商、网站主题以及所有者信息,使这些网站看起来彼此之间没有关联。在这些网站发布的内容中,会策略性地加入指向目标网站的链接。通过这种方式,网站所有者试图将链接权重(也称为 Link Equity 或 “Link Juice”)从 PBN 网站传递到目标网站。 PBN 的目的,是让目标网站看起来像是自然地从多个相互独立的网站获得了反向链接。如果操作得当,这种方式可能会在短期内提升关键词排名、增加自然搜索曝光度,并为目标网站带来更多来自搜索结果的流量。 Streaming Film Nonton Film gratis Jasa Backlink Download Anime Batch

Read More
Categories News

如何拥有明星项目同款性能监控平台|GPM 2.0公开Demo现已开放 – UWA问答 | 博客 | 游戏及VR应用性能优化记录分享

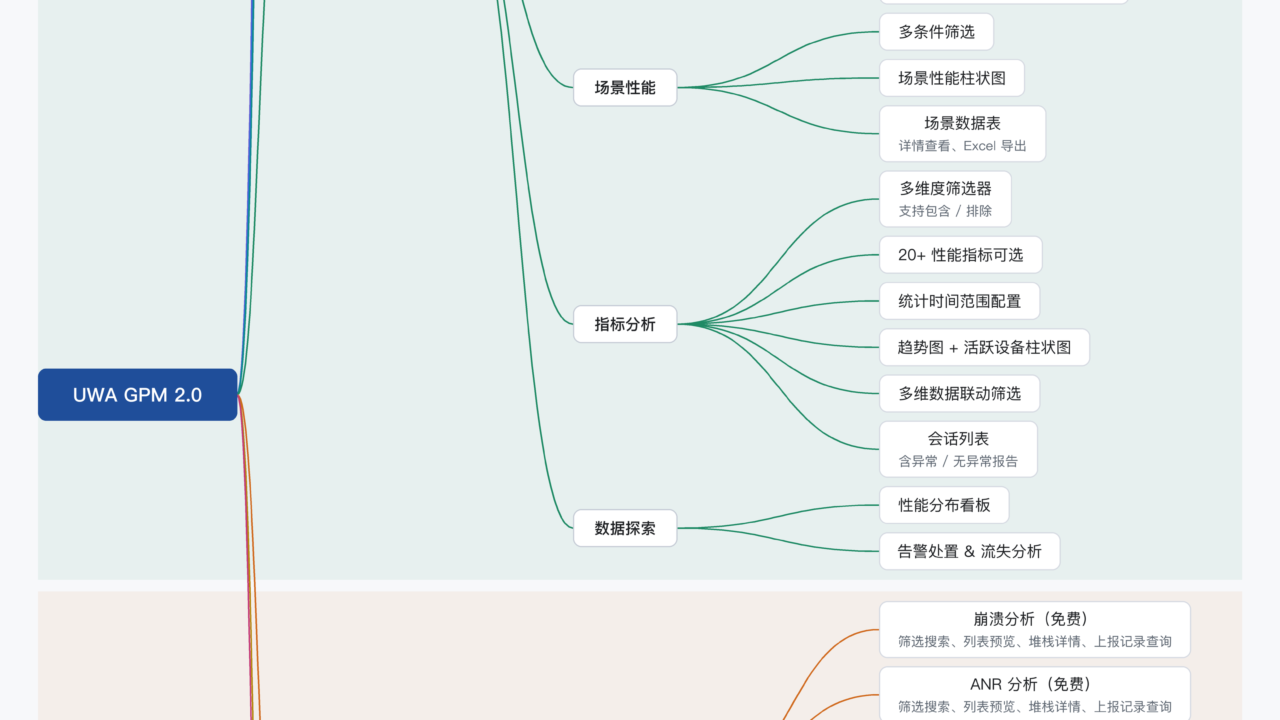
游戏很多质量风险只会暴露在真实玩家真机环境中。 线下测试很难复现偶现闪退;大盘均值会掩盖低端机型卡顿;发生故障缺少完整现场证据;高价值玩家默默掉帧流失,往往要等到客诉爆发才后知后觉。 GPM 2.0以完整玩家会话为底座,打通大盘观测、AI智能分析、故障现场回溯、设备画质分档诊断、核心玩家专项守护的线上质量闭环。本次公开演示Demo,搭载模拟项目样本,完整复现真实项目分析工作流,直观感受平台分析逻辑与交互形态。 以下为 GPM 2.0 完整能力全景图。 ⚠️ 说明:GPM 2.0脑图为产品当前全部能力集合;Demo为模拟样本环境,用于体验绝大多数模块页面交互与分析思路,不支持真实项目问题排查。 通过GPM 2.0 Demo,可以快速体验的核心能力包括: ◆ 数据大盘总览活跃设备、崩溃/ANR/错误日志、FPS、温度、内存大盘;多维度Top排行,看见被平均值掩盖的线上风险。 ◆ AI智能体小Q页面内置AI总结;自然语言问答;后台哨兵异常主动告警;支持MCP。 ◆ 故障定位链路 玩家行为洞察/单点追踪:操作时序与性能、异常截帧联动 异常筛查:崩溃、ANR、错误日志聚合,堆栈&符号表解析效果 性能下钻:版本|场景|指标分析,直达单条玩家会话 ◆ 两大专项业务分析 设备体验雷达:设备画像、画质分档诊断、项目实测机型天梯 核心玩家守护:高价值用户分桶、专项告警、性能 流失关联分析 ◆ 配套工具GPM Insights报告、硬件分析、版本/场景对比、配置设置等模块均可浏览。 ► 立即访问GPM 2.0 Demo(由于功能模块较多,建议在电脑端浏览) 看完Demo,想要了解正式环境、SaaS/私有云部署方案,可以通过以下方式预约您的UWA顾问!技术支持:gpm-support@uwa4d.com微信:18683824 关于GPM 2.0 UWA GPM 2.0 是专为上线及测试阶段游戏项目打造的高性能监测平台。它不仅能深度捕捉宏观性能数据,更创新采用性能无损截帧技术,在不影响玩家体验的前提下,助力开发者全面掌握玩家端运行关键细节,从多维度优化游戏性能,实现从“玩家投诉后救火” 到 “问题发生前预警” 的核心转变。 产品全景与理念 • 全景定位/成果背书/GPM…

Read More
Categories News

Epic 免費遊戲《Buried Stars》、《System Shock 2》限時領取,10/8 截止

Epic Games 本週限時免費遊戲 本週 Epic Games 遊戲商店一次送出兩款 Windows 版限時免費遊戲,分別是 LINE Games 的懸疑視覺小說《Buried Stars》(中文名稱:深埋之星),以及 Nightdive Studios 重製的太空恐怖射擊《System Shock 2: 25th Anniversary Remaster》。領取時間為台灣時間 2026 年 10 月 1 日晚上 11:00 起,至 10 月 8 日晚上 11:00 前,在期限內加入遊戲庫即可永久保留,趕緊把握機會。 兩款遊戲的類型差異很大,《Buried Stars》提供繁體中文文字,適合喜歡劇情與推理的玩家,另一款《System Shock 2: 25th Anniversary Remaster》沒有中文,需要能夠讀懂英文才方便遊玩。領取前可先看下方各自的資訊與說明。 《Buried Stars》限時免費領取資訊 活動截止:台灣時間 2026 年 10…

Read More
Categories News

DrawCall达到900,渲染耗时为何不高 – UWA问答 | 博客 | 游戏及VR应用性能优化记录分享

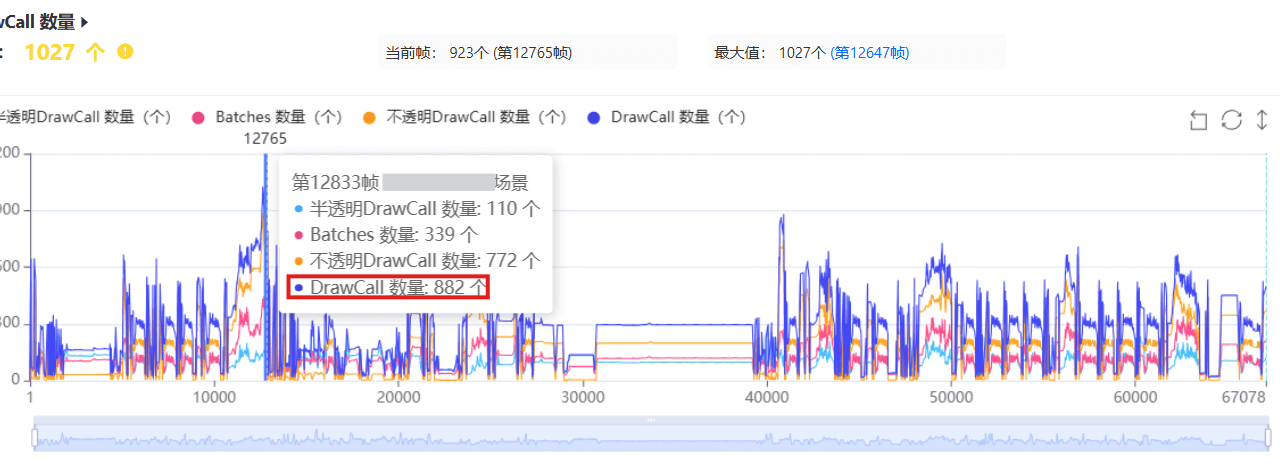
1)DrawCall达到900,渲染耗时为何不高2)动态目标技能还适合Timeline吗 这是第495篇UWA技术知识分享的推送,精选了UWA社区的热门话题,涵盖了UWA问答、社区帖子等技术知识点,助力大家更全面地掌握和学习。 UWA社区主页:community.uwa4d.comUWA QQ群:793972859 本次推送的实战案例来自于使用UWA服务的项目的真实且典型的问题。UWA将关键线索、定位路径与处理建议整理成了可复用的案例笔记,便于大家快速对照、排查自身项目中的同类问题。 实战案例 Q:URP项目的内城场景中,DrawCall能达到700~900,但Batches只有240~260,渲染模块耗时也没有明显升高。这种情况下还需要继续压低DrawCall吗? A:当前不需要将降低DrawCall作为首要优化项。开启SRP Batcher后,Unity可以降低为使用相同Shader变体的材质准备和提交DrawCall时的CPU开销。它不一定会直接减少DrawCall,因此可能出现DrawCall较高,但CPU侧渲染耗时仍然较低的情况。 GOT Online报告显示当前场景的DrawCall为700~900,Batches为240~260,渲染模块耗时也没有明显升高,说明这些绘制调用暂未形成明显的CPU侧渲染压力。此时单独压低DrawCall,未必能带来可观的帧率收益。 不过,渲染模块耗时主要反映CPU侧的渲染开销,不能据此排除GPU侧压力。后续可以保留相同设备、镜头和场景作为基线,重点观察以下变化: Batches和渲染模块耗时同步升高说明CPU侧的批次准备和提交压力正在增加。可以使用Frame Debugger检查SRP Batcher状态及新Batch产生的原因,重点关注Shader变体或关键字切换、Pass差异,以及材质所用Shader是否兼容SRP Batcher。 GPU Clocks明显升高或持续处于较高区间说明压力更可能出现在GPU侧,需要进一步排查Overdraw、Shader复杂度、顶点数量以及透明物体、粒子或后处理效果的屏幕覆盖范围。 仅DrawCall上升,其余指标基本稳定暂时不需要针对DrawCall单独优化,可以继续观察场景内容增加后,Batches、渲染模块耗时和GPU Clocks是否同步变化。 因此,当前没有必要只为了降低DrawCall数值进行优化。后续如果DrawCall和Batches持续增加,并伴随渲染模块耗时明显升高,再通过Frame Debugger定位合批中断和CPU侧提交开销的来源;如果相关耗时仍然稳定,则继续观察即可。 实战案例 Q:项目使用Timeline编辑角色技能的特效、音效和播放顺序,但技能还要根据敌人位置动态计算特效的起点和终点。大量单位同时攻击时,单帧出现了28次Timeline相关调用。这类战斗技能还适合继续使用Timeline吗? A:Timeline可以继续使用,但建议只负责技能表现编排,动态目标和战斗逻辑仍由技能系统处理。 Timeline适合组织播放顺序相对固定的动画、特效和音效。目标选择、起点、终点、飞行轨迹及命中判断会随战斗状态实时变化,如果全部交由Timeline控制,就需要在运行过程中持续传递和绑定战斗数据,增加表现层与战斗逻辑之间的耦合。 单帧出现28次Timeline相关调用,说明大量单位同时释放技能时,这部分工作会集中发生。但调用次数本身不能证明Timeline已经成为性能瓶颈,还需要结合堆栈确认这些调用主要发生在Playable或PlayableGraph创建、数据绑定(Binding),还是Graph评估(Evaluate)阶段,并观察对应的单次耗时和总耗时。 建议按照以下方式拆分职责: 技能系统负责释放时机、目标选择、起止位置、飞行轨迹和命中判断。 表现模块根据技能系统提供的数据,按时间播放特效、动画和音效。 Timeline保留在剧情、Boss出场、角色Cut-in等播放内容固定、触发频率较低的完整演出中。 现有项目不需要一次性重构。可以先选择普通攻击或触发频率较高的小技能进行调整,在相同设备、单位数量和战斗流程下,对比调整前后的Timeline相关调用次数、逻辑代码耗时和帧率。 如果调用次数和CPU耗时同步下降,说明拆分有效,可以继续扩大调整范围;如果调用次数下降,但整体CPU耗时和帧率变化不明显,说明Timeline并不是当前主要瓶颈,需要继续根据堆栈排查其他CPU热点。 无论是社区里开发者们的互助讨论,还是AI基于知识沉淀的快速反馈,核心都是为了让每一个技术难题都有解、每一次踩坑都有回响。希望这些从真实开发场景中提炼的经验,能直接帮你解决当下的技术卡点,也让你在遇到同类问题时,能更高效地找到破局方向。 封面图来源于网络 今天的分享就到这里。生有涯而知无涯,在漫漫的开发周期中,我们遇到的问题只是冰山一角,UWA社区愿伴你同行,一起探索分享。欢迎更多的开发者加入UWA社区。 UWA官网:www.uwa4d.comUWA社区:community.uwa4d.comUWA学堂:edu.uwa4d.com官方技术QQ群:793972859 PakarPBN 私人博客网络(Private Blog Network,简称 PBN)是由个人或组织控制的一组网站,主要用于向一个“目标网站”(Money Site)建立反向链接,从而影响其在 Google 等搜索引擎中的排名。PBN 的核心理念建立在反向链接对 Google 排名算法的重要性之上。由于…

Read More
Categories News

noTube 免費 YouTube 轉 MP3、MP4,支援超過 1300 個平台

本文重點:noTube 是免安裝、免註冊的線上影片下載與轉檔工具,支援 YouTube、TikTok、Instagram、Facebook、X 等超過 1300 個平台,貼上影片網址就能轉成 MP3、M4A、WAV 音訊或 MP4 影片,也能下載 YouTube 播放清單。 平常滑 YouTube、TikTok、Instagram 或 Facebook,看到喜歡的影片或音樂想存下來,常常會遇到同一個問題:這款工具只支援 YouTube,或是只能抓 TikTok 影片,格式選擇也很陽春,想要不同畫質或音質,還得再找別的網站,來回切換相當麻煩,有沒有多合一的下載器可以更方便解決問題呢? noTube 是什麼? 本文要介紹的「noTube」是一個免費的線上影片下載與轉檔工具,不需要安裝任何應用程式或瀏覽器擴充功能,也不用註冊帳號,打開網頁貼上網址就能使用。它最大的特色是同時支援 YouTube、TikTok、X(Twitter)、Instagram、Facebook、Twitch、Dailymotion 等多個平台,一共超過 1300 個平台(完整支援清單),不用再依照來源網站分別找對應的下載工具。 noTube 格式支援也相當完整,音訊部分提供 MP3、MP3 HD、M4A、WAV 四種選擇,視訊部分則有 MP4、MP4 HD、MP4 2K、3GP、FLV,可以依照儲存空間或播放裝置選擇合適的規格,其中 MP4 2K 需付費訂閱 noTube Plus,免費版影片畫質最高 1080p。除了單支影片,noTube 也支援下載 YouTube 播放清單,一次最多可處理 100 支影片,不用一支一支貼網址轉檔。只需要 YouTube 轉檔的話,YouTube 轉…

Read More
Categories News

GPU压力已经偏高,WaitForPresent为何不明显

1)GPU压力偏高,WaitForPresent为何不明显 2)目标120FPS,GPU还剩多少性能余量 这是第494篇UWA技术知识分享的推送,精选了UWA社区的热门话题,涵盖了UWA问答、社区帖子等技术知识点,助力大家更全面地掌握和学习。 UWA社区主页:community.uwa4d.com UWA QQ群:793972859 本次推送的实战案例来自于使用UWA服务的项目的真实且典型的问题。UWA将关键线索、定位路径与处理建议整理成了可复用的案例笔记,便于大家快速对照、排查自身项目中的同类问题。 实战案例 Q:UWA GOT Online报告显示GPU Clocks在部分区间已经偏高,Fragment Shaded也显示单帧处理的像素量较大,说明GPU侧存在一定压力,为什么Gfx.WaitForPresentOnGfxThread却不明显? A:Gfx.WaitForPresentOnGfxThread反映的是渲染线程到达同步点后,等待GPU完成相关工作的时间。这个节点不明显,不能说明GPU没有压力。 CPU和GPU会并行工作。如果CPU侧本身耗时较高,渲染线程到达同步点时,GPU可能已经完成了部分任务,因此最终记录到的等待时间不会很长。 这类情况不能只看Gfx.WaitForPresentOnGfxThread,还要结合GPU Clocks、实时帧率和目标帧率确认GPU整体压力,再判断开销来自图元数量、像素绘制量,还是Shader复杂度。 项目偏2D,GOT Online报告中可以看到Input Primitive整体较低,说明提交给GPU绘制的图元数量不是主要问题。相比之下,Fragment Shaded更值得关注。 当前设备的渲染分辨率约为1080×2400,一屏约为250万像素;报告中Fragment Shaded局部达到3500万~5000万次,相当于一帧处理约14~20屏的像素量,说明需要重点排查重复绘制和全屏Pass。 排查时可以依次检查半透明粒子、重叠UI、全屏特效,以及Bloom、Blur和多次上下采样等后处理。同时检查当前激活的4~5个相机,确认其中两个可以关闭的相机是否仍在产生额外开销。 验证时保持设备、场景和画质设置不变,每次只关闭一项内容。如果Fragment Shaded和GPU Clocks同步下降,就可以继续沿着重复绘制和全屏Pass排查;仍无法确认时,再结合Frame Debugger或RenderDoc查看具体的DrawCall和Pass。 实战案例 Q:项目目标是120FPS,后续还要增加角色、特效和后处理,怎么判断GPU还剩多少性能余量? A:可以根据目标设备的GPU额定频率和目标帧率,反推单帧可使用的GPU Clocks范围。当前测试设备的GPU额定频率约为902MHz,项目目标帧率为120FPS:902MHz÷120FPS≈750万cycles/帧。 750万cycles/帧是根据设备额定频率反推的理论参考上限。当前GOT Online报告中,部分区间的GPU Clocks已经超过这一水平,说明这些区间可能影响120FPS目标。 移动设备无法保证长时间维持额定频率运行。随着功耗和温度升高,GPU还可能出现降频,因此实际制定预算时需要预留一定空间。暂时按理论上限的80%估算:750万×80%≈600万cycles/帧。 600万cycles/帧可以作为当前设备档位的GPU预算参考,但不是通用的固定安全线。后续增加角色、特效、阴影和后处理时,应在同一设备、同一场景下对比GPU Clocks,确认新增内容消耗了多少预算。 接近或超过预算后,可以按照画面贡献和性能开销,依次减少同屏特效、关闭部分阴影、降低后处理规格,或者将Bloom从1/2采样调整为1/4采样。 GPU Clocks只能衡量总体预算,不能直接换算成还能增加多少个特效。不同特效的屏幕覆盖范围、Overdraw和Shader复杂度不同,需要通过对照测试确认实际开销。 不同GPU架构的单cycle计算能力也不同,因此GPU Clocks不能跨设备直接比较。更合适的做法是为每个硬件档位固定一台标准测试机,用于比较不同版本和画质方案。 最终还要通过长时间测试,持续观察GPU Clocks、帧率、温度和功耗。如果新增内容后GPU Clocks超过参考预算,并伴随帧率下降或运行一段时间后的性能波动,就需要降低渲染负载。 无论是社区里开发者们的互助讨论,还是AI基于知识沉淀的快速反馈,核心都是为了让每一个技术难题都有解、每一次踩坑都有回响。希望这些从真实开发场景中提炼的经验,能直接帮你解决当下的技术卡点,也让你在遇到同类问题时,能更高效地找到破局方向。 封面图来源于网络…

Read More
Categories News

GPT-6 Sol、Luna 要付費嗎?API 價格砍半一次看

本文重點:GPT-6 Sol 與 GPT-6 Luna 是 OpenAI 在旗艦模型 GPT-6 Astra 之後推出的兩款平價模型,Sol 主打寫程式與 AI Agent 任務,Luna 適合摘要、擷取資料這類大量又單純的工作,API 價格比 GPT-5.6 同級模型便宜一半,免費用戶也能在 ChatGPT 桌面版使用 Luna。 AI 模型的競爭越來越激烈,前一篇才介紹 Anthropic 的 Claude Opus 5.5,OpenAI 在同一天就推出兩款新模型 GPT-6 Sol 與 GPT-6 Luna。這個月初 OpenAI 已經發表旗艦模型 GPT-6 Astra,但 Astra 能力強、價格也高,不是每件工作都需要動用到它。這次的 Sol 與 Luna 就是 GPT-6 家族裡的平價選擇,用和 Astra…

Read More